LLM 評審是什麼,研究實際量了什麼
LLM 評審(LLM-as-a-judge)是請一個能力強的語言模型取代人、或在人之前評估一份輸出。這個說法因 Zheng 等人 2023 年的論文〈Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena〉而普及,文中描述三種做法:成對比較,由評審在兩個答案中選較好的一個或判定平手;單一答案評分,為一個答案打分;以及參考答案引導評分,把答案與參考解比較。
它最常被引用的結果常少了前提。在 MT-Bench 上、只計算非平手票時,GPT-4 作為成對評審與人類專家投票的一致率為 85%,而專家彼此之間的一致率是 81%。這是作者針對 2023 年六個模型的開放式對話答案所量到的一致率,並不代表你的標籤、你的語言或現在的模型,因此本頁其餘部分都在談如何量測你自己的評審。
這裡的評審是什麼
一套規則是一到四個問題:choice 在 2–12 個準則標籤中選一個、noul 依 true 與 false 準則給出是非機率、score 落在 2–7 個有序等級上。一次請求會為單筆資料回答全部問題,不論問一個或四個都算 1 點。每個答案都以你送出的 id、你指定的型別回傳;超出準則範圍的答案會被拒收,不會交回給你。
這與請聊天模型評分不同:沒有生成的理由要讀,也沒有自由形式的評語要解析,你存下的是自己寫的問題的答案。這也代表評審的品質等於你的準則品質:指示越模糊,模型對「說不上來的東西」回答得越有自信。
{
  "text": "INV-2291 的退款重複入帳兩次,客戶要求停止第二筆轉帳。",
  "questions": [
    {"id": "outcome", "type": "choice", "instructions": "這則紀錄反映哪種結果?", "criteria": {"resolved": "問題已結案。", "in_progress": "仍有人正在處理。", "blocked": "等待第三方。"}},
    {"id": "is_negative", "type": "noul", "instructions": "這則紀錄是否指出我們流程的失誤?", "criteria": {"true": "指出我們流程中的錯誤。", "false": "說明進度或一般交接。"}}
  ],
  "threshold": 0.9
}自己寫規則,或生成草稿後檢查
你可以自己寫問題,也可以用簡短描述讓生成器提出規則:從已登入的工作階段呼叫 POST /api/judges,prompt 為 5–800 字元,並指定用語的語言。生成器是固定模型上的聊天 completion,其輸出會先通過 API 相同的型別化問題驗證,才會顯示給你。
一次生成花費 1 點,失敗會退還。沒有任何東西會自動執行:生成結果是一份草稿,由你編輯後自行執行。請檢查準則是否互斥、等級是否有順序,以及是否有問題索取個人資料。把 prompt 當成資料:生成器只寫規則,不做任何判定。
curl https://jevapi.pro/api/judges \
  -H 'Content-Type: application/json' \
  -H 'Idempotency-Key: judge-support-triage-v1' \
  -b 'jev_session=YOUR_SESSION' \
  -d '{"prompt": "判定一則客服紀錄是已解決、處理中或受阻,並說明是否指出我方流程的失誤。", "locale": "zh-tw"}'\n\n{
  "judge": {
    "name": "客服紀錄覆核",
    "questions": [{"id": "outcome", "type": "choice", "instructions": "這則紀錄反映哪種結果?", "criteria": {"resolved": "…", "in_progress": "…", "blocked": "…"}}]
  },
  "model": "openai/gpt-4.1-mini",
  "id": "6f2c1a4e-9d7b-4c11-8f3a-2b5e9c0d1a77",
  "latencyMs": 2140,
  "credits": 19
}已知偏誤,以及實際測過的修正方法
同一篇論文量了三種偏誤。位置偏誤:使用預設提示時,兩個答案對調順序後 GPT-4 仍給出相同判定的比例只有 65%,較弱的評審更低。冗長偏誤:把清單塞進換句話說、毫無新資訊的項目後,在 23 個案例中 GPT-3.5 與 Claude-v1 有 91.3% 偏好較長的答案,GPT-4 為 8.7%。自我偏好偏誤(偏袒自家模型的答案)在部分評審身上出現,但作者表示以現有資料無法確認。評審也會把自己單獨能解出的數學題評錯。
論文也測了修正方法:每組答案以兩種順序各評一次,兩次一致才算勝出;加入參考答案,讓 GPT-4 在十道數學題上的評分失誤從 20 次中 14 次降到 3 次;加入少量範例,讓位置一致性從 65% 提高到 77.5%,但提示成本約為四倍。
針對單筆資料的型別化問題,在設計上就避開了成對比較的位置效應,也沒有可被篇幅灌水的自由評語;但它無法消除措辭效應。請直接測試:調換準則順序、在不改變意思下改寫指示,確認保留資料集上的答案維持不變。
Agent 評審:被評的是一整段執行軌跡時
Agent 評審(agent-as-a-judge)把這個概念延伸到代理系統。Zhuge 等人(2024)讓評審能用工具建立代理產出的工作區結構、定位相關檔案、閱讀內容並搜尋執行軌跡,並套用在 DevAI 上:一個包含 55 個 AI 開發任務、365 項階層式需求的基準。在他們的實驗中,agent 評審與三位人工評估者共識的一致率約 90%,LLM 評審約 70%,成本與時間約為人工評估的 2.3%。
本工作區一次只評一筆資料,不會瀏覽檔案或重播代理的執行過程。若要評估代理,請把可評的部分拆成單筆資料,每次請求一項需求或一個步驟;需要開檔或執行程式碼的檢查,交給人或專門的 agent 評審。
用人員標記檢查評審,而不是看它自己的信心
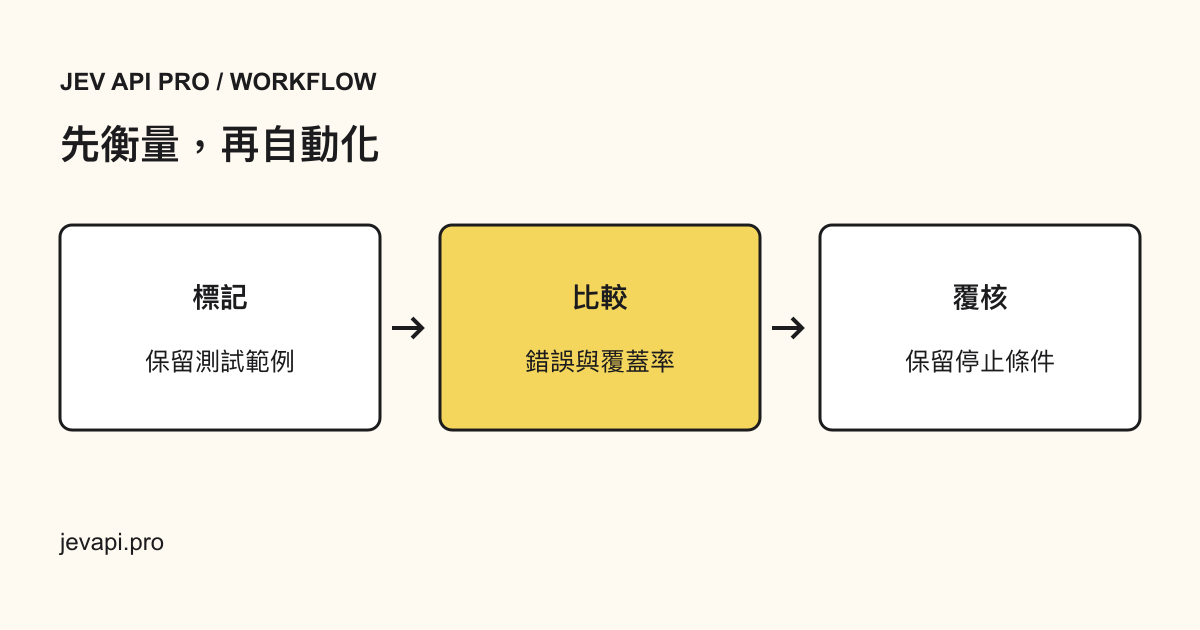
把答案與熟悉業務的人寫下的標記逐題比較,並計算代價高的錯誤,而不是整體一致率。機率是模型自己的輸出,不是實測準確率;在你的資料上,高數值仍可能出錯。
只要指示、準則或模型改變,就重跑一次比較,並把請求 id 與模型名稱和結果一起保存,日後的比較才有意義。把不確定的紀錄送去人工覆核,而不是把評審當成最終決定;對外公布的準確率只能來自你自己的保留資料集。