Qué significa LLM como juez y qué midió la investigación
Usar un LLM como juez significa pedir a un modelo de lenguaje potente que evalúe un resultado en lugar de una persona, o antes que ella. El término lo popularizaron Zheng et al. en «Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena» (2023), que describe tres variantes: comparación por pares, en la que el juez elige la mejor de dos respuestas o declara empate; calificación de una sola respuesta, en la que puntúa una respuesta; y calificación guiada por referencia, en la que compara la respuesta con una solución de referencia.
Su resultado principal suele citarse sin sus condiciones. En MT-Bench, contando solo los votos sin empate, GPT-4 como juez por pares coincidió con votantes humanos expertos el 85 % de las veces, mientras que los expertos coincidieron entre sí el 81 %. Es la coincidencia sobre respuestas abiertas de chat de seis modelos de 2023, medida por los autores. No dice nada de tus etiquetas, tu idioma ni los modelos actuales, y por eso el resto de esta página trata de medir tu propio juez.
Qué es un juez aquí
Una regla es de una a cuatro preguntas: choice sobre 2–12 criterios, noul sobre criterios true y false, o score sobre 2–7 niveles ordenados. Una solicitud las responde todas para un registro y cuesta un crédito, pida una pregunta o cuatro. Cada respuesta vuelve con el id que enviaste y con el tipo que pediste; una respuesta fuera de tus criterios se rechaza en lugar de devolverse.
Esa es la diferencia con pedir a un modelo de chat que puntúe una respuesta. No hay justificación generada que leer ni veredicto libre que interpretar: lo que guardas es la respuesta a una pregunta tuya. También significa que el juez vale lo que valen tus criterios: una instrucción vaga produce una respuesta segura sobre nada en concreto.
{
  "text": "Se emitió dos veces el reembolso de INV-2291; el cliente pidió detener la segunda transferencia.",
  "questions": [
    {"id": "outcome", "type": "choice", "instructions": "¿Qué resultado registra esta nota?", "criteria": {"resuelto": "El caso está cerrado.", "en_curso": "Alguien sigue trabajando en él.", "bloqueado": "Espera a un tercero."}},
    {"id": "is_negative", "type": "noul", "instructions": "¿La nota informa de un fallo nuestro?", "criteria": {"true": "Informa de un error en nuestro proceso.", "false": "Informa de avances o de un traspaso normal."}}
  ],
  "threshold": 0.9
}Escribe las reglas o genera un borrador y revísalo
Puedes escribir las preguntas o describir la decisión en un texto breve y dejar que el generador las proponga: POST /api/judges desde una sesión iniciada, con un prompt de 5–800 caracteres y un idioma para la redacción. El generador es una completion de chat sobre un modelo fijo y su salida se valida con las mismas preguntas tipadas que acepta la API antes de mostrártela.
Una generación cuesta un crédito y, si falla, se devuelve. Nada se ejecuta automáticamente: el conjunto generado es un borrador que editas y ejecutas tú. Comprueba que los criterios sean mutuamente excluyentes, que los niveles estén ordenados y que ninguna pregunta pida datos personales. Trata el prompt como datos: el generador escribe reglas, no decide nada.
curl https://jevapi.pro/api/judges \
  -H 'Content-Type: application/json' \
  -H 'Idempotency-Key: judge-support-triage-v1' \
  -b 'jev_session=YOUR_SESSION' \
  -d '{"prompt": "Decide si una nota de soporte está resuelta, en curso o bloqueada, y si informa de un fallo de nuestro proceso.", "locale": "es"}'\n\n{
  "judge": {
    "name": "Revisión de notas de soporte",
    "questions": [{"id": "outcome", "type": "choice", "instructions": "¿Qué resultado registra esta nota?", "criteria": {"resuelto": "…", "en_curso": "…", "bloqueado": "…"}}]
  },
  "model": "openai/gpt-4.1-mini",
  "id": "6f2c1a4e-9d7b-4c11-8f3a-2b5e9c0d1a77",
  "latencyMs": 2140,
  "credits": 19
}
Clasificación por lotes y exportación · Tutorial de Jev en OpenRouter
Sesgos conocidos y las correcciones que se probaron
El mismo artículo midió tres sesgos. Sesgo de posición: con el prompt por defecto, GPT-4 mantuvo el veredicto al intercambiar las dos respuestas solo en el 65 % de los pares, y los jueces más débiles, menos aún. Sesgo de extensión: cuando una lista se rellenaba con elementos reformulados que no aportaban nada, GPT-3.5 y Claude-v1 prefirieron la respuesta larga en el 91,3 % de 23 casos y GPT-4 en el 8,7 %. El sesgo de autopromoción, favorecer las respuestas del propio modelo, apareció en algunos jueces, pero los autores no pudieron confirmarlo con sus datos. Los jueces también calificaron mal preguntas de matemáticas que sabían resolver por separado.
También se probaron correcciones. Juzgar cada par dos veces, en ambos órdenes, y contar una victoria solo si los dos veredictos coinciden. Añadir una respuesta de referencia, que redujo los fallos de GPT-4 en diez preguntas de matemáticas de 14 de 20 a 3 de 20. Añadir ejemplos few-shot, que elevó la consistencia de posición del 65 % al 77,5 % con un prompt unas cuatro veces más caro.
Una pregunta tipada sobre un solo registro evita por construcción los efectos de posición entre pares, y no hay veredicto libre que la extensión pueda inflar. No elimina los efectos de redacción. Pruébalos directamente: cambia el orden de los criterios, reformula una instrucción sin cambiar su sentido y comprueba que las respuestas de tu conjunto reservado no cambian.
Agente como juez: cuando lo que se juzga es una trayectoria
El agente como juez extiende la idea a los sistemas agénticos. Zhuge et al. (2024) dieron al juez herramientas para mapear el espacio de trabajo que produjo un agente, localizar los archivos relevantes, leerlos y buscar en su trayectoria, y lo aplicaron a DevAI, un benchmark de 55 tareas de desarrollo de IA con 365 requisitos jerárquicos. En sus experimentos, el agente juez coincidió con el consenso de tres evaluadores humanos en cerca del 90 % de los requisitos, frente a cerca del 70 % de un LLM juez, con aproximadamente el 2,3 % del coste y del tiempo de la evaluación humana.
Este espacio juzga un registro cada vez; no explora archivos ni reproduce la ejecución de un agente. Si evalúas agentes, divide lo que se puede juzgar en registros, un requisito o un paso por solicitud, y deja a una persona o a un agente juez dedicado las comprobaciones que exigen abrir archivos o ejecutar código.
Zhuge et al., Agent-as-a-Judge (arXiv 2410.10934) · Espacio de agentes
Compara al juez con personas, no con su propia confianza
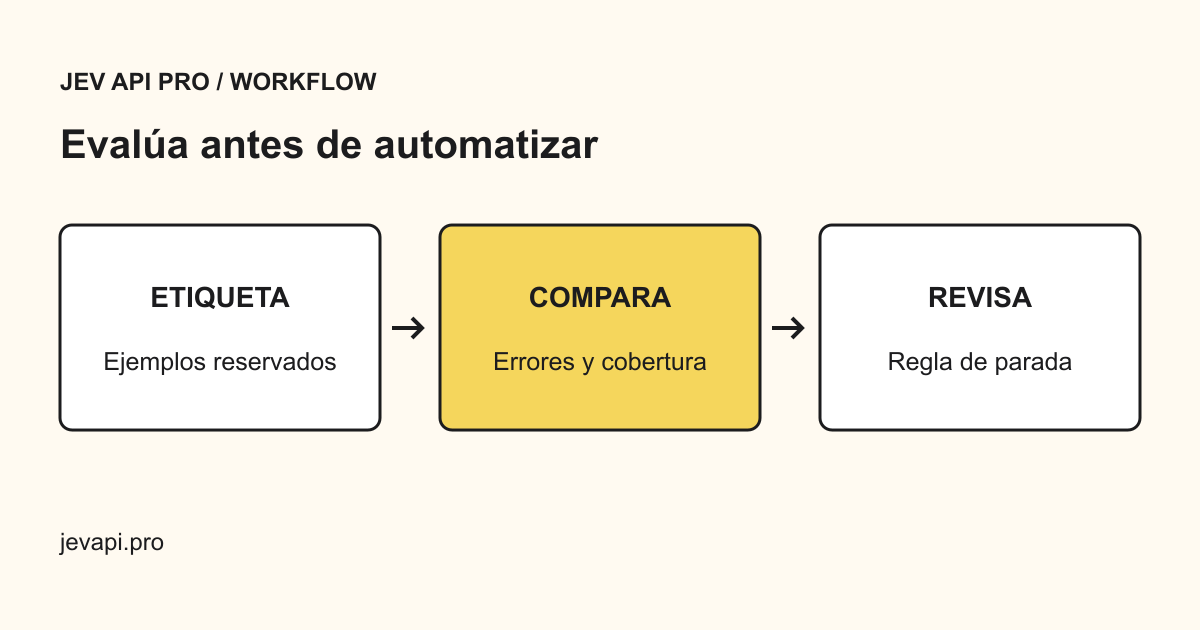
Compara las respuestas con etiquetas escritas por alguien con conocimiento, pregunta por pregunta, y cuenta los errores costosos en lugar de la coincidencia global. Una probabilidad es la salida del propio modelo: no es una exactitud medida y un valor alto puede estar equivocado con tus datos.
Repite la comparación cada vez que cambien las instrucciones, los criterios o el modelo, y guarda el identificador de la solicitud y el nombre del modelo con los resultados. Envía los registros dudosos a revisión en lugar de tratar al juez como decisión final, y publica cifras de acierto solo desde tu propio conjunto reservado.
Evalúa la clasificación antes de automatizar · Decisiones con revisión humana · OpenRouter: SDK de TypeSafe y Jev