GUIDES

內容審核信心門檻與覆核佇列成本計算機

把誤攔正常客戶的損失、漏放違規內容的風險與審核人員時薪放進同一張表,找出總成本最低的信心門檻,並直接匯出對應的 Jev API 審核請求。

JEV / MODERATION THRESHOLD & QUEUE SIMULATOR錯誤風險與人工審核工時最佳化

At threshold 0.86: 18,370 auto-decided · 6,630 sent to human review (26.5%) · Est. monthly total $1,671.50.

Cost-minimizing cutoff for your error weights is computed live as you adjust costs.

對應門檻的 Jev API 審核請求

curl --fail-with-body --connect-timeout 5 --max-time 35 \
  https://jevapi.pro/api/v1/decisions \
  -H 'Authorization: Bearer YOUR_JEV_API_KEY' \
  -H 'Content-Type: application/json' \
  -H 'Idempotency-Key: mod-item-20261116' \
  -d '{
  "text": "User post content to evaluate against community and safety rules.",
  "questions": [
    {"id": "policy_violation", "type": "noul", "instructions": "Does the text violate published spam, abuse, or off-platform solicitation rules?", "criteria": {"true": "Condition holds in the message.", "false": "Condition does not hold in the message."}},
    {"id": "moderation_action", "type": "choice", "instructions": "Select the queue outcome under policy.", "criteria": ["allow", "human_review", "remove_violation"]}
  ],
  "threshold": 0.86
}'

本試算以校準曲線呈現門檻與覆核工時的權衡關係;正式上線前建議先用批次處理實測 200 筆歷史標記樣本。

準備好在正式環境用 Jev 1.13 執行這組規則了嗎?

可先購買單次 $29 加值包(1,800 點,不過期),或選擇 Builder 方案(30 天 $39 · 3,500 點)立即建立伺服器端 API 金鑰。

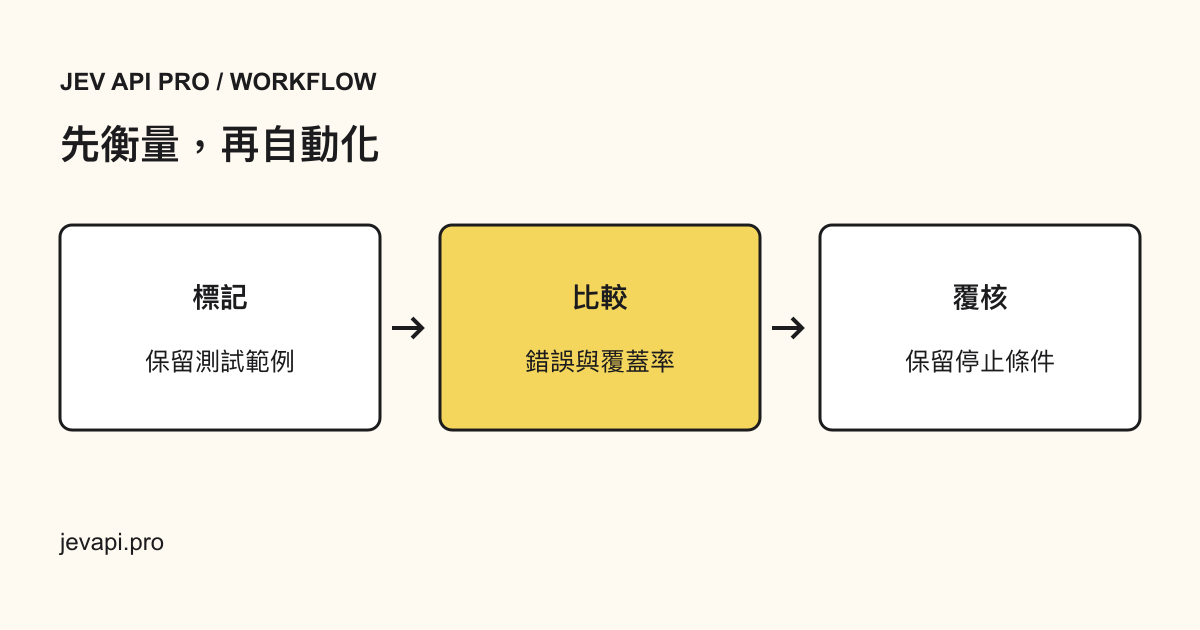
先標記保留測試集,再比較模型結果並覆核錯誤,通過評估後才改動流程。

分別量化誤判攔截與漏判放行的真實商業代價

直接套用預設的 0.85 門檻,等於假設「誤刪正常買家留言」與「漏放詐騙導流連結」代價相同。在真實營運場景中,漏放一筆惡意違規往往遠高於花 30 秒交由人工覆核的工時成本。

調整上方每月筆數、違規比例與人工審核秒數,即可即時觀察門檻拉高或放寬時,自動處理量與總營運費用的變化。

信心門檻設定指南 · OpenAI Moderation API 對照

為何自訂書面政策優於固定分類的黑盒過濾器

通用安全端點只能偵測固定類別的仇恨或暴力字眼,無法識別平台特有的私下導流、競品洗版或合約合規條款。透過 noul 是非題搭配三向分流標籤,團隊能照自己的書面規範執行自動化初篩。

不同信心門檻區間的佇列行為對照
門檻區間自動化行為特徵預估人工覆核比例適合場景
0.70 – 0.79高比例自動分流,邊界案例誤判風險較高低(8% – 15%)低風險內部標籤整理
0.80 – 0.89兼顧自動處理效率與模糊案例攔截中(18% – 30%)社群留言與一般客服
0.90 – 0.98嚴格把關,稍有不確定即轉人工審核高(32% – 55%)電商上架、帳務與風控

JSON 決策結構產生器 · 查看預付點數方案

用 $29 單次加值包在歷史樣本上完成實測

複製上方產生的 curl 指令,先針對團隊已人工標註的 200 至 500 筆歷史資料做離線對照。單次 $29 加值包提供 1,800 點且不自動續約,足以在正式串接前驗證真實準確率。

到 Playground 試跑單筆審核 · 選購 $29 加值包或 $39 Builder

審核門檻計算機常見問題

如果模型未回傳 confidence 分數會怎麼處理?

只要 confidence 為 null 或低於設定門檻,API 一律將 needsReview 設為 true,絕不自動放行模糊內容。

試算結果可以直接當成正式環境的準確率保證嗎?

不行。試算曲線僅供評估門檻與人力的成本方向,上線前請務必以自家真實標註樣本進行驗證。

試做一次判定 ↗

繼續工作流程

應用情境

OpenAI Moderation API 與自訂政策分類

OpenAI Moderation API 免費、容易接入,擅長一件事:依一份固定的傷害類別清單,為文字與圖片評分。但多數社群與電商平台的政策,還包含許多根本不屬於傷害類別的規則。本頁說明這個端點回傳什麼、它的分類在哪裡不夠用,以及如何在上面疊加你自己的政策標籤,而不把分數當成決定。

閱讀指南 ↗
每日獎勵

每天免費領取 2 點

每個 UTC 日可免費領取 2 點,領取七天共 14 點。無需購買,點數永不過期。

    每日 00:00 UTC 重置,不要求連續簽到。

    試做一次判定 →

    在您的工作區中進行下一個決策。

    每天 1 次匿名試用 · 註冊送 20 點數 · 試用免綁卡

    登入 ↗

    告訴我們你的需求

    請說明要分類的工作流程、預期用量與所需結果。我們將透過 email 回覆。

    10–2,000 個字元。切勿包含密碼、API 金鑰或付款資料。