GUIDES

Calculadora de umbral de moderación y cola de revisión

Modela el equilibrio entre errores automáticos y horas de revisión humana antes de fijar un umbral de confianza, y exporta al instante la petición JSON para Jev API.

JEV / MODERATION THRESHOLD & QUEUE SIMULATOROPTIMIZADOR COSTE DE ERROR VS REVISIÓN

At threshold 0.86: 18,370 auto-decided · 6,630 sent to human review (26.5%) · Est. monthly total $1,671.50.

Cost-minimizing cutoff for your error weights is computed live as you adjust costs.

PETICIÓN DE MODERACIÓN GENERADA

curl --fail-with-body --connect-timeout 5 --max-time 35 \
  https://jevapi.pro/api/v1/decisions \
  -H 'Authorization: Bearer YOUR_JEV_API_KEY' \
  -H 'Content-Type: application/json' \
  -H 'Idempotency-Key: mod-item-20261116' \
  -d '{
  "text": "User post content to evaluate against community and safety rules.",
  "questions": [
    {"id": "policy_violation", "type": "noul", "instructions": "Does the text violate published spam, abuse, or off-platform solicitation rules?", "criteria": {"true": "Condition holds in the message.", "false": "Condition does not hold in the message."}},
    {"id": "moderation_action", "type": "choice", "instructions": "Select the queue outcome under policy.", "criteria": ["allow", "human_review", "remove_violation"]}
  ],
  "threshold": 0.86
}'

La simulación ilustra el equilibrio entre errores y carga manual; mide tu umbral real sobre un lote etiquetado en Procesamiento por lotes.

¿Listo para ejecutar este esquema con Jev 1.13 en producción?

Empieza con una recarga única de $29 (1,800 créditos sin caducidad) o elige Builder ($39 por 30 días · 3,500 créditos) y crea tu clave API de servidor.

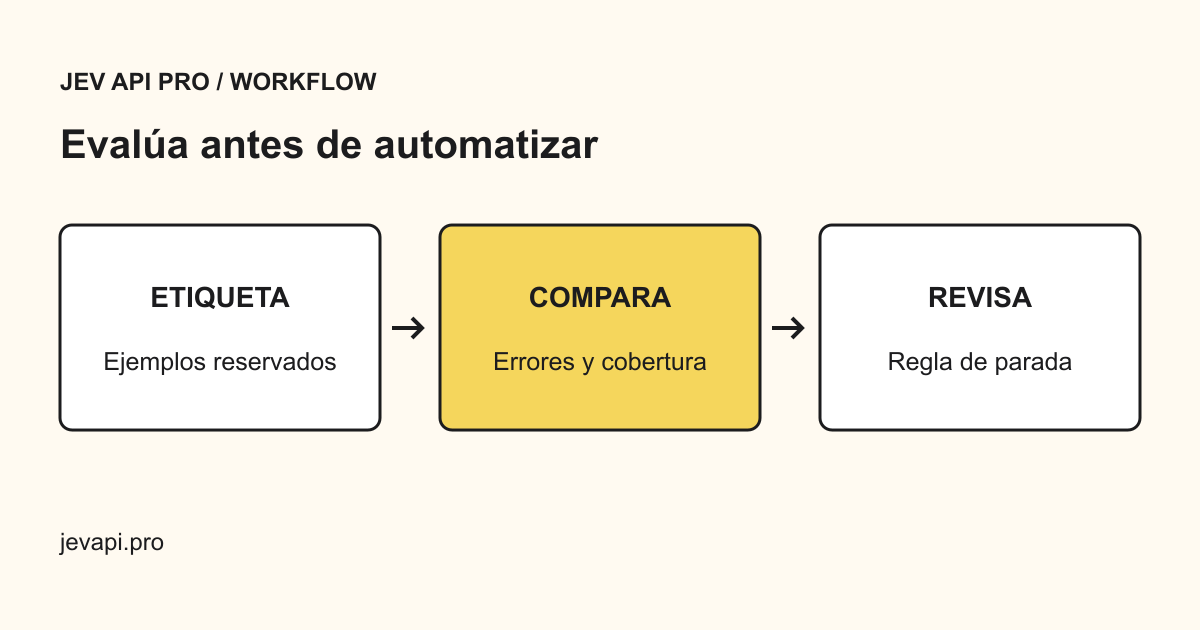
Etiqueta ejemplos reservados, compara las decisiones del modelo y revisa errores antes de cambiar el flujo.

Asigna un coste real a cada tipo de error

Un umbral fijo de 0,85 asume que bloquear por error a un cliente legítimo cuesta lo mismo que dejar pasar fraude o spam comercial. En moderación real, una infracción no detectada suele costar mucho más que enviar un mensaje dudoso a una revisión manual de 30 segundos.

Ajusta el volumen mensual, el coste por falso positivo y negativo y la tarifa por hora del equipo para observar cómo varía el gasto operativo total al mover el umbral.

Guía de umbrales de confianza · Comparativa con OpenAI Moderation API

Reglas propias frente a taxonomías genéricas cerradas

Los filtros genéricos detectan daños universales pero pasan por alto reglas propias de tu negocio, como desvíos de pago fuera de plataforma o spam de revendedores. Combinar una pregunta noul con una elección de cola permite aplicar tu política escrita exacta.

Comportamiento orientativo por rango de umbral
Rango de umbralEfecto operativoCarga de revisiónCaso recomendado
0,70 – 0,79Alta automatización, mayor exposición en casos límiteBaja (8% – 15%)Etiquetado interno de bajo riesgo
0,80 – 0,89Equilibrio entre filtrado automático y revisiónMedia (18% – 30%)Comentarios UGC y soporte
0,90 – 0,98Filtro estricto; toda duda pasa a una personaAlta (32% – 55%)Pagos, anuncios y cumplimiento

Constructor de esquemas JSON · Planes y recargas

Comprueba el umbral con tu propio conjunto etiquetado

Copia el comando curl generado arriba y evalúa entre 100 y 500 casos históricos ya resueltos por tu equipo. Con la recarga única de $29 dispones de 1.800 créditos sin suscripción para medir resultados reales antes de automatizar.

Probar en el área de pruebas · Ver recarga de $29 y plan Builder

Preguntas sobre el umbral de moderación

¿Qué ocurre si el modelo no devuelve puntuación de confianza?

Cuando confidence es null o inferior al umbral enviado, needsReview vuelve siempre como true para evitar decisiones automáticas silenciosas.

¿Esta calculadora garantiza una tasa exacta de acierto?

No. Es un modelo orientativo de costes; debes medir la precisión real sobre una muestra representativa de tus propios mensajes.

Probar una decisión ↗

Continúa tu proceso

Casos de uso

API de moderación de OpenAI frente a clasificación con tu política

La API de moderación de OpenAI es gratuita, se integra rápido y hace bien una tarea: puntuar texto e imágenes frente a una lista fija de categorías de daño. Casi todas las políticas de comunidades y marketplaces contienen además reglas que no son categorías de daño. Esta página explica qué devuelve el endpoint, dónde termina su taxonomía y cómo añadir tus propias etiquetas sin confundir una puntuación con una decisión.

Leer la guía ↗
BONO DIARIO

2 créditos gratis cada día

Reclama 2 créditos gratis por día UTC: 14 en siete días de recogida. No hace falta comprar. Los créditos no caducan.

    Se reinicia a las 00:00 UTC. No se requiere una racha.

    Probar una decisión →

    Lleva la prueba a tu espacio.

    1 intento anónimo al día · 20 créditos de registro · Prueba sin tarjeta

    Acceder ↗

    Cuéntanos qué necesitas

    Describe el proceso que quieres clasificar, el volumen previsto y el resultado que necesitas. Respondemos por correo.

    10–2.000 caracteres. No incluyas contraseñas, claves API ni datos de pago.