什麼是潛在客戶評分,積分模型的極限在哪裡
潛在客戶評分(lead scoring)為名單排序,讓業務把時間花在最可能成交的人身上。典型模型會依「適配度」加分,例如產業、公司規模或職務;依「互動」加分,例如造訪價格頁、申請展示或點擊信件;遇到學生信箱之類的訊號則扣分。HubSpot、Salesforce 等 CRM 同時提供手動規則評分,以及用歷史成交資料訓練的預測評分。
這兩種做法都只處理結構化欄位,都讀不懂「我們第三季前每月要分派 4,000 張客服單」這句話,而它同時說明了用途、數量與期限,正是資深業務最先找的三件事。這段文字通常就在表單欄位或第一封信裡,對互動紀錄還很少的新名單來說,往往是你手上最強的訊號。
把自由文字轉成成熟度等級
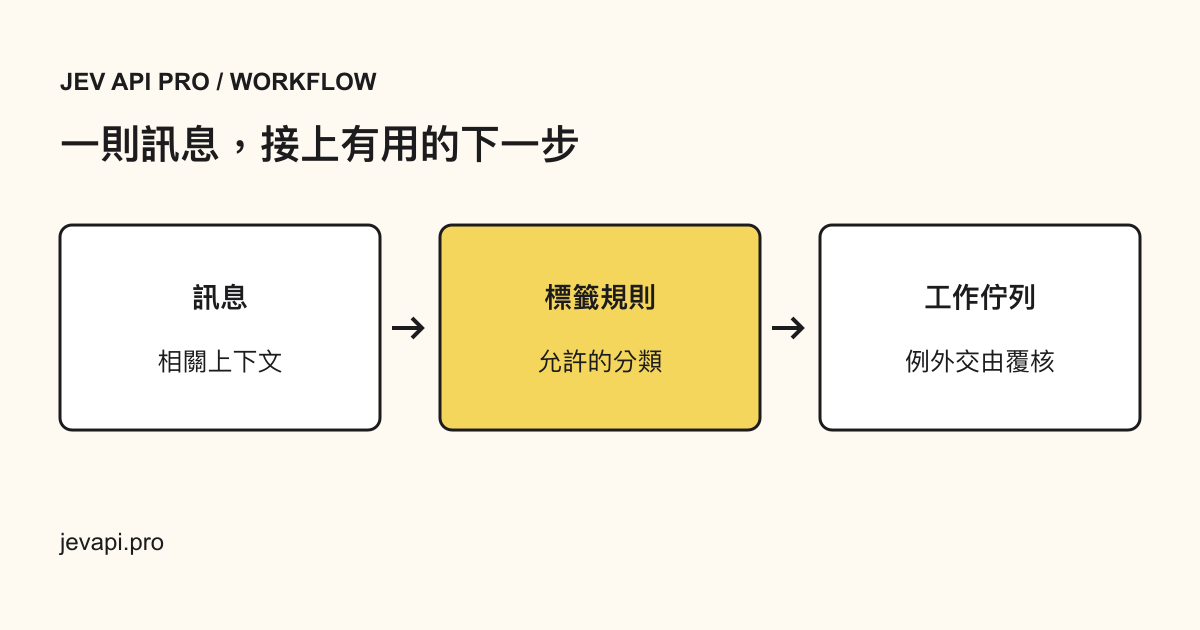
與其要模型給 0 到 100 分(容易產生虛構的精確度),不如請它把文字放進少數幾個有書面定義的等級。多數團隊四級就夠:高,對方說明了用途、數量與時程;中,用途清楚但缺少數量或時程;初期,只有好奇、沒有具體需求;不適合,需求不在你的服務範圍。
真正要花心思的是等級定義。請像交代新進業務一樣寫下來,也寫明哪些不能算數:不得從姓名、信箱網域或寫作風格推測預算、職級或任何個人特質。下面的請求可以直接貼進 Playground。
{
  "text": "我們每月在 Zendesk 處理約 4,000 封客服信,希望第三季前依團隊自動分派,有兩位工程師可以投入。",
  "instructions": "依潛在客戶自己寫的內容判斷購買成熟度。高:有明確用途、數量與時程。中:有用途但沒有數量或時程。初期:只是好奇。不適合:需求不在服務範圍。不得推測預算、年齡、性別或地區。",
  "labels": ["高", "中", "初期", "不適合"],
  "threshold": 0.75
}把等級併入既有分數
保留原本的適配度與互動積分,把等級當成多一項輸入。簡單的做法是:高加 30 分、中加 15 分、初期 0 分、不適合扣 30 分,再交給 CRM 加總。先用這類數字起步,之後用下一節的校準結果調整,而不是憑感覺。
把等級、模型有提供時的信心值,以及請求識別碼存進聯絡人紀錄。信心值低於門檻時完全不要加分,而是標記給人查看。默默吸收猜測的分數,比坦白說「不確定」的分數更糟。
三位潛在客戶,三個等級
「我們的客服團隊有 40 人,使用 Freshdesk,每月約 6,000 張單,希望下個月底前上線建議分派。」這是「高」:有用途、數量與日期。加上分數,讓業務當天回覆。
「想找方法自動分類客戶意見。」這是「中」:需求真實,但沒有數量、工具或時程。好的回覆是只問一個問題,例如每月收到多少則意見,而不是直接約展示。
「只是想看看 AI 能為公司做什麼。」這是「初期」,適合提供有用的資源,而不是業務電話。若訊息要的是圖片生成或聊天機器人建置,對分類 API 來說就是「不適合」,誠實告知並指引其他方向才是體貼的做法。
先用成交資料驗證,再依賴等級
取出 200 到 500 筆歷史名單,連同原始表單文字與結果(成交、流失或從未回應)。用你的規則分類文字,再依等級比較轉換率。如果「高」的轉換率沒有明顯高於「中」,代表定義沒有區分出真正重要的差異,該改的是文字定義,而不是再加分數。
雙向檢查錯誤。從未回覆的名單被評為「高」,通常表示規則獎勵的是細節多寡而非購買意圖;已成交的案子被評為「不適合」則是代價最高的錯誤,請逐筆檢視。產品、目標市場或等級文字有變動時,都要重新驗證一次。
讓人留在流程中,並保持資料乾淨
等級改變的是優先順序,而不是能否被服務:每位潛在客戶都應得到回覆,任何人都不該只因一次分類就被自動拒絕。讓業務一鍵修改等級並記錄原因,這些修正正是改進規則最好的材料。
只送出判定需要的文字,移除電話、地址,以及任何你不會貼進客服單的內容。若要大量評分既有名單,請用批次分類整個檔案,而不是逐筆迴圈呼叫;結果再透過你自己的整合寫回 CRM,讓評分邏輯保持可稽核。