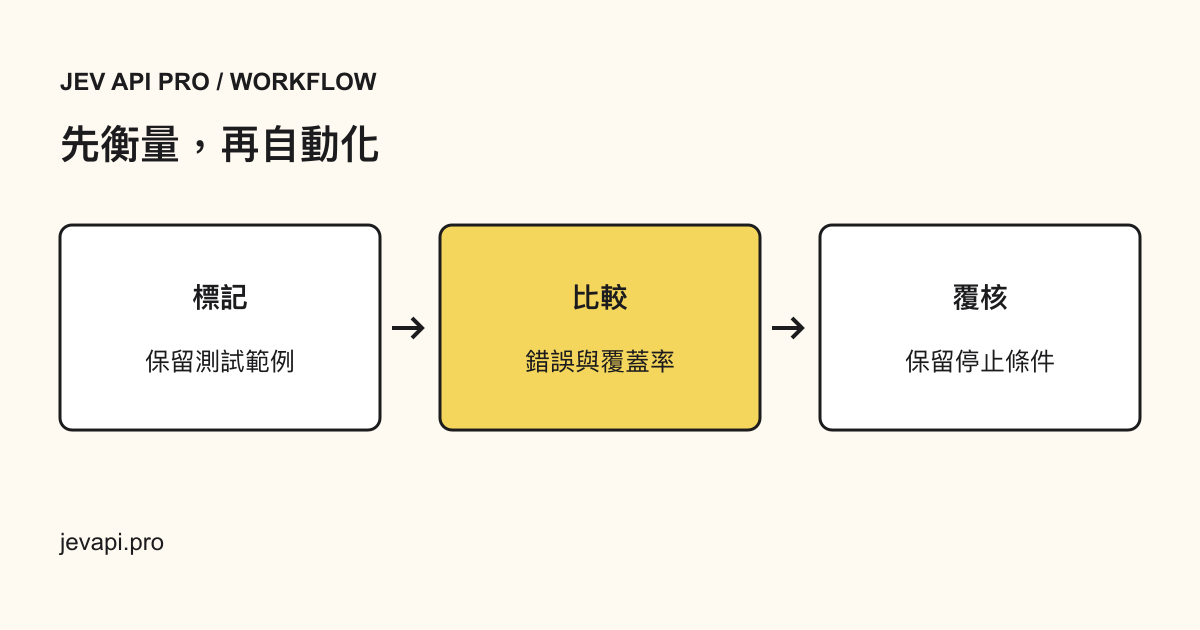
先算清楚一次評估,再選擇門檻
以下是示意計算,並非 Jev 的實測跑分。假設獨立測試集有 100 則訊息,在某個門檻下,80 則獲得自動接受,其中 78 則符合參考標籤、2 則錯誤,其餘 20 則送往覆核。自動化覆蓋率為 80%,自動接受結果的正確率為 78 / 80 = 97.5%。這兩個數字都無法直接說明那兩次錯誤造成多大損失。
依標籤和後果拆開檢查錯誤。產品標記錯誤與誤批退款的代價不同。權限檢查仍放在分類器之外,再用相同樣本和模型版本比較門檻。不要用最後的獨立測試集來挑選門檻,又把同一批結果稱為獨立驗證。
示意計算,非可執行程式,也不是 Jev 實測
held_out = 100
automated_correct = 78
automated_wrong = 2
review = 20
coverage = (78 + 2) / 100 = 80%
automated_accuracy = 78 / 80 = 97.5%
保留可重現的評估紀錄
在自己的系統保存原始資料列識別碼、人工標籤、規則版本、請求指定的模型、回應中的實際模型、門檻、請求識別碼與結果。另行記錄整趟請求的延遲和已確認的失敗。若底層模型會改變,只記供應商名稱並不足以追溯。
先採用只記錄建議、不修改客戶資料的觀察模式。上線前指定能停用自動化的負責人,並定義停止條件。標籤、模型版本或訊息語言改變後,應重新評估;介面已有翻譯,不代表模型在各語言有相同品質。
保留不參與調整的測試集
寫下標籤及其定義,請熟悉業務的人員標記具代表性的資料。先釐清意見分歧,再把標籤當成參考答案。另外保留一批不拿來調整指令的資料,作為獨立測試集。
計算真正重要的錯誤
整體正確率可能掩蓋少數重要分類的失誤。逐一統計各標籤的錯誤、覆核模糊案例,並衡量所選門檻下仍有多少工作需要人工處理。把實際流量中的語言與來源管道差異納入評估。
分階段啟用自動化
先顯示建議,將模型判定與既有處理結果比較,再只自動化一個可逆步驟。若錯誤率或覆核量上升,應有清楚的停止條件。將請求識別碼和模型名稱連同評估結果保存,後續比較才有共同基準。