Ejecuta un ejemplo completo en Python
Instala el cliente con python -m pip install requests. Configura JEV_API_KEY en el servidor con una clave de cuenta que tenga acceso API activo y créditos. Define JEV_IDEMPOTENCY_KEY una sola vez por solicitud lógica: genera un UUID con python -c "import uuid; print(uuid.uuid4())" y conserva ese valor para los reintentos. No publiques estos valores ni los pongas en código del navegador.
Guarda el ejemplo como classify.py y ejecuta python classify.py. El texto y las etiquetas están definidos; los errores HTTP detienen la ejecución antes de leer una respuesta de éxito. La salida muestra una propuesta y needsReview, sin asignar tickets ni modificar otro sistema. Cambia la clave solo para una nueva solicitud deliberada; si desconoces el resultado de la conexión, conserva la clave y el contenido exacto.
import json
import os
import requests

api_key = os.environ["JEV_API_KEY"].strip()
request_key = os.environ["JEV_IDEMPOTENCY_KEY"].strip()
if not api_key:
    raise ValueError("JEV_API_KEY must not be empty")
if not 8 <= len(request_key) <= 100:
    raise ValueError("JEV_IDEMPOTENCY_KEY must be 8-100 characters")

payload = {
    "text": "I was charged twice for the same order.",
    "instructions": "Choose the team responsible for this request.",
    "labels": ["Billing", "Support", "Access"],
    "threshold": 0.85,
}
response = requests.post(
    "https://jevapi.pro/api/v1/decisions",
    headers={
        "Authorization": "Bearer " + api_key,
        "Idempotency-Key": request_key,
    },
    json=payload,
    timeout=(5, 30),
)
response.raise_for_status()
answer = response.json()
print(json.dumps({
    "id": answer["id"],
    "choice": answer["choice"],
    "needsReview": answer["needsReview"],
}, ensure_ascii=False, indent=2))Lee la respuesta como evidencia, no como veredicto
Una decisión nueva responde 201 con id, choice, confidence, probabilities, needsReview, model y latencyMs; una petición de cuenta también devuelve los créditos restantes. confidence es null cuando el modelo la omite, y entonces needsReview es true, igual que cuando la confianza queda por debajo de tu umbral.
probabilities solo se valida por dominio y límites. Nada garantiza que sus valores sumen uno ni que el mayor corresponda a la etiqueta devuelta: lee choice en lugar de ordenar un diccionario para adivinar la respuesta, y trata una etiqueta fuera de tu lista como un rechazo, no como un valor por defecto.
Procesa un archivo sin cargos duplicados
Envía las filas de un CSV de forma secuencial y guarda cada clave junto al identificador estable del registro, el contenido exacto y su estado. No uses la posición de la fila: cambia al insertar filas. Un cambio de reglas o de entrada constituye una nueva solicitud, no un reintento.
Un timeout, una desconexión o un 502/503 genérico de una pasarela no demuestra que no hubo cargo. Detén la asignación automática y repite el mismo contenido con la misma clave para recuperar el resultado. Un 409 request_running conserva esa clave; un 409 request_failed auténtico confirma el fallo registrado y permite una nueva clave tras resolver la causa. No cambies la clave solo por un error de proxy.
Un 402 indica créditos insuficientes. Un 401 puede indicar una clave ausente, revocada o con acceso vencido; comprueba la cuenta antes de repetir. Ante un 429 respeta Retry-After si existe y limita los reintentos con espera progresiva. Este ejemplo envía una vez y expone los errores: tu ejecutor decide qué repetir. El espacio por lotes ya conserva el estado de cada fila y exporta sin incluir el texto original.
Clasificación por lotes y exportación · Abrir el espacio por lotes · Códigos de error y recuperación
Elige una API o un modelo propio
Un modelo scikit-learn o transformer puede ser económico si las etiquetas son estables, tienes datos de entrenamiento adecuados y puedes operar la inferencia. No es gratis por fila: cómputo, mantenimiento, evaluación y revisión humana tienen coste. Compara coste total y latencia medidos en tu carga real.
Una API evita operar el modelo, pero implica dependencia de la red, procesamiento del texto por el proveedor y cargos por uso. Un modelo local puede encajar mejor si necesitas trabajar sin conexión o mantener los datos en tu infraestructura. Ninguna opción convierte la confianza en garantía.
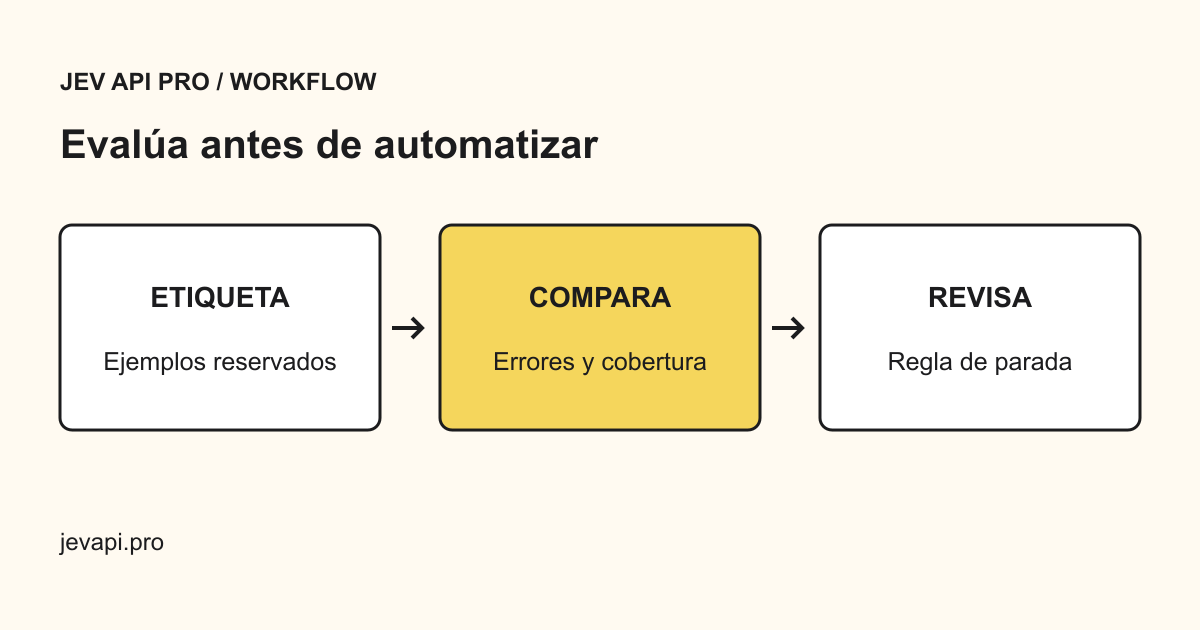
Evalúa ambas opciones con las mismas filas reservadas y etiquetas revisadas por personas, incluidos casos ambiguos. Empieza guardando sugerencias, automatiza solo lo respaldado por la evaluación y conserva los resultados needsReview en una cola humana existente.