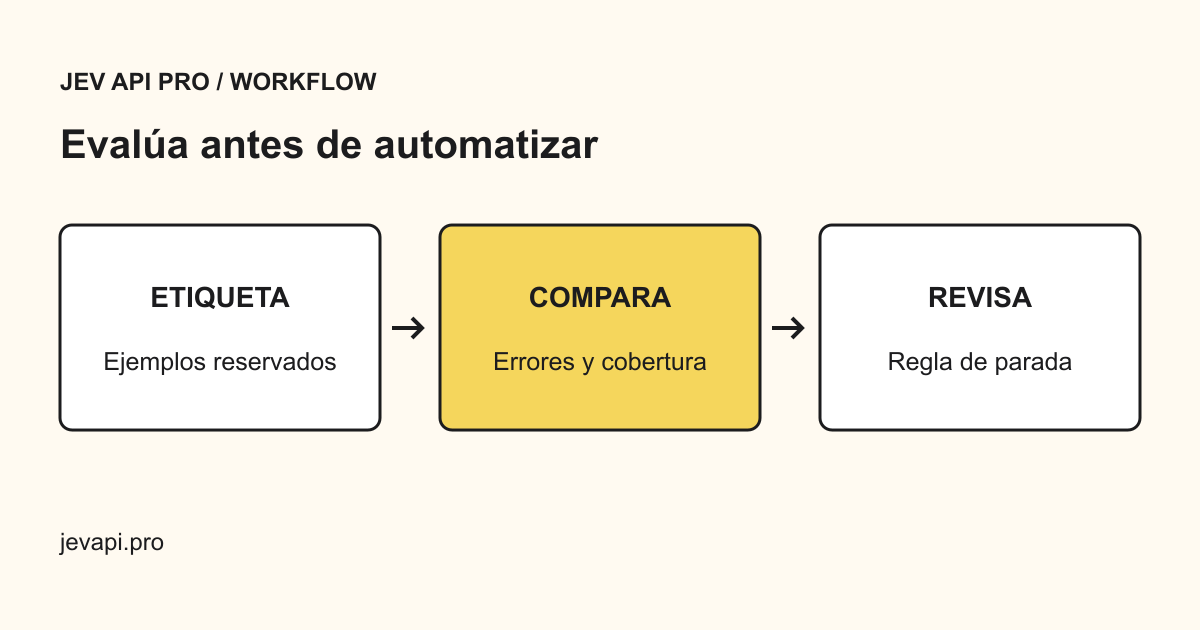
Calcula una evaluación antes de elegir el umbral
Ejemplo ilustrativo, no un benchmark medido de Jev: de 100 mensajes reservados, 80 se aceptan automáticamente; 78 aciertan y dos fallan. Otros 20 requieren revisión. La cobertura es 80% y el acierto entre decisiones automáticas es 78 / 80 = 97,5%. Eso no indica cuánto daño causaron los dos errores.
Separa errores por etiqueta y consecuencia. Un tag equivocado no cuesta lo mismo que un reembolso indebido. Compara umbrales con los mismos ejemplos y versión, y no ajustes las reglas con el conjunto final reservado.
Solo ilustrativo
100 mensajes = 78 aciertos automáticos + 2 errores + 20 revisiones
cobertura = 80%
acierto automático = 97,5%
Conserva un registro reproducible
Guarda en tu sistema el identificador de fila, etiqueta humana, revisión de reglas, modelo solicitado y devuelto, umbral, ID y resultado. Mide la latencia completa y los fallos confirmados por separado.
Empieza en modo sugerencia sin modificar registros del cliente. Define responsable y regla de parada. Reevalúa al cambiar etiquetas, modelo o idioma; traducir la interfaz no demuestra la misma calidad del modelo.
Reserva un conjunto de prueba
Define las etiquetas y pide a una persona con conocimiento que clasifique registros representativos. Resuelve desacuerdos antes de usarlos como referencia. Reserva ejemplos que no utilices para ajustar instrucciones.
Cuenta los errores relevantes
La exactitud global puede ocultar fallos en una categoría pequeña pero importante. Cuenta errores por etiqueta y trabajo manual restante. Incluye diferencias de idioma y canal presentes en tus datos.
Publica por etapas
Empieza con sugerencias y automatiza después una acción reversible. Define cuándo detener el flujo si aumentan fallos o revisiones. Guarda identificadores y nombre del modelo para comparar futuras evaluaciones.