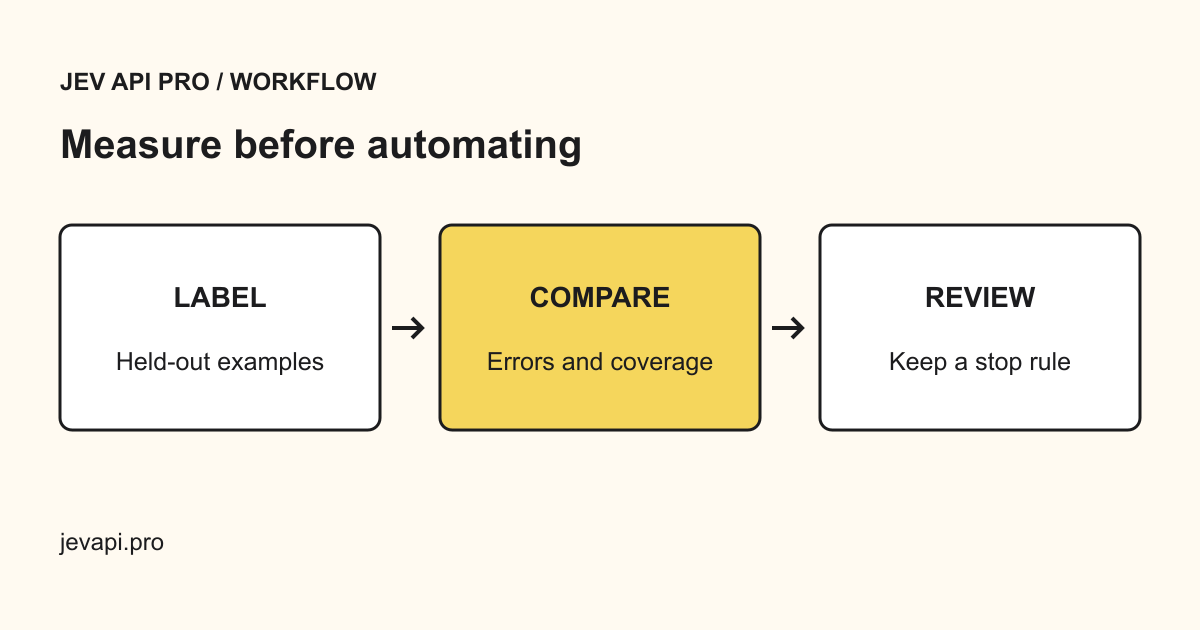
しきい値を選ぶ前に、まず 1 回評価を通す
これは説明用の計算で、Jev の実測ベンチマークではありません。ホールドアウトのデータが 100 件あるとします。あるしきい値で 80 件が自動承認され、そのうち 78 件が参照ラベルと一致し、2 件が誤りでした。残り 20 件は人による確認に回ります。自動化の適用率は 80%、自動承認された結果の正確さは 78 / 80 = 97.5% です。どちらの数字も、その 2 件の誤りが深刻な損害を出したかどうかは教えてくれません。
誤りはラベルと結果の重さで分けて見てください。商品タグの誤りと、誤って承認した返金では、コストが違います。権限の判定は分類器の外に置いたまま、同じ例と同じモデル版でしきい値を比較します。最後のホールドアウトでしきい値を選び、それを独立した検証結果と呼んではいけません。
説明用。実行できるコードでも Jev の実測でもない
held_out = 100
automated_correct = 78
automated_wrong = 2
review = 20
coverage = (78 + 2) / 100 = 80%
automated_accuracy = 78 / 80 = 97.5%再現できる評価記録を残す
元の行の識別子を自社のシステムに残し、人によるラベル、ルールの版、要求したモデル、実際に返ったモデル、しきい値、リクエスト識別子、結果を一緒に保存します。エンドツーエンドの遅延と、確認できた失敗は別々に記録してください。基盤のモデルが変わるなら、提供元の名前だけでは追跡できません。
まずは提案のみのモードで始め、顧客のデータを書き換えられないようにします。自動化を止められる責任者を決め、公開前に停止条件を明文化します。ラベル、モデル版、メッセージの言語が変わったら再評価します。画面が翻訳されていることは、その言語で同じ品質という証拠にはなりません。
検証用データは分けておく
ラベルとその定義を書き出します。業務を知る人に代表的なレコードをラベル付けしてもらいます。意見が割れた場合は、基準として使う前に解消します。指示を調整するために使わない、別のセットを確保してください。
重要な誤りを数える
全体の正確さは、小さくても重要なカテゴリの失敗を隠します。ラベルごとに誤りを数え、曖昧な事例を確認し、選んだしきい値で手作業がどれだけ残るかを測ります。実際の流入にある言語とチャネルの差も含めてください。
段階的に展開する
まずは提案モードから始めます。モデルの判定と既存の結果を比較し、可逆なステップだけを自動化します。失敗率や確認件数が上がったら止める条件を決めておきます。リクエスト識別子とモデル名を評価結果と一緒に保存すると、後の比較が意味を持ちます。