先比較輸出契約,再比較模型
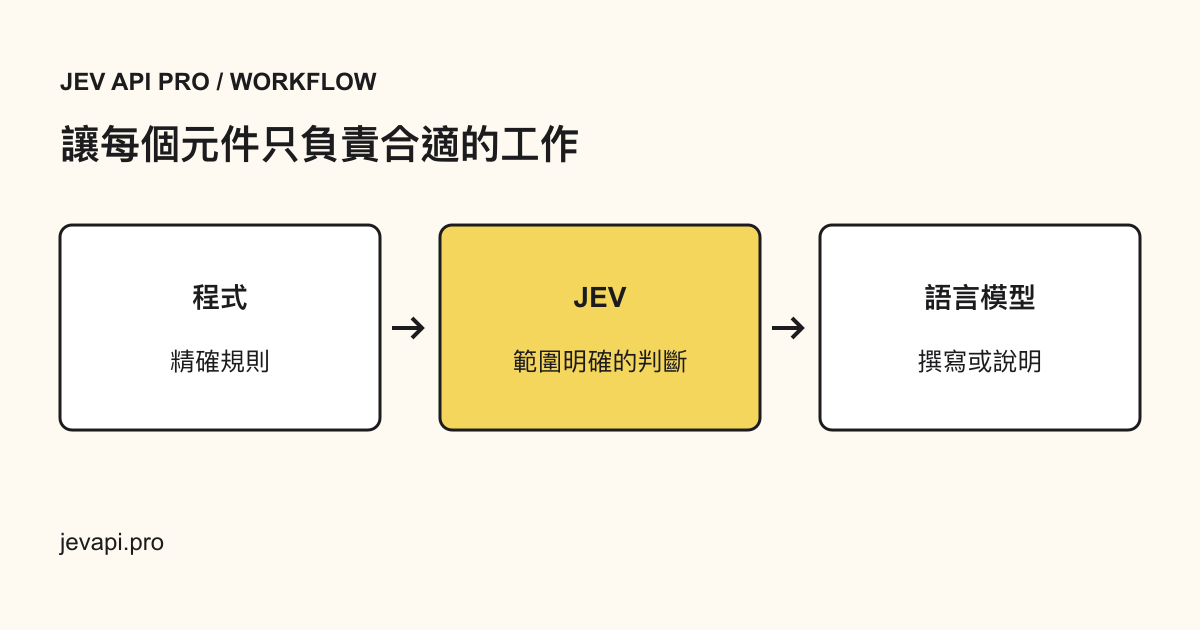
Jev 接收情境與具型別的問題,依官方定義提供選項判定、評分或 Noul 命題估計。它不撰寫回覆、不輸出長篇推理,也不執行工具。若需要電子郵件、摘要、解釋或程式碼,應評估生成式模型。部分生成式模型也支援受約束的結構化輸出,因此能回傳 JSON 本身不足以作為選擇 Jev 的理由。
寫清楚下一步真正需要的欄位。若是既有的佇列名稱,就比較分類方法;若是對客戶有用的回答,就評估文字生成。兩者可以合作,但額外分類步驟應能改善實測成果、降低整體成本,或讓維運更簡單。
用一張客服單釐清責任
假設訊息是「我被扣款兩次,而且無法登入帳戶」。單一標籤可能漏掉其中一個問題。你需要的是選擇第一個負責團隊、找出多項問題,還是撰寫回覆?三者的驗收條件不同。若只決定初次分派,就應先寫清楚是否由帳務優先處理,並為資訊不足的情況保留覆核結果。
測試期間先把輸出當成建議。分類標籤不應自行觸發退款、修改帳戶或寄出信件;動作與權限仍由應用程式控制。若同時生成回覆,需另外驗證內容正確性,分對佇列不代表文字回答就正確或有用。
把答對與有信心分開衡量
標籤格式有效,仍可能選錯。TypeSafe 的文件說明,Choice 與 Score 的 confidence 由答案分布推導,不是對某一次答案正確性的獨立保證。它也不能直接等同於請生成模型自行宣告的把握程度;兩種信號的來源和失誤方式不同。
用團隊已標記的樣本選擇門檻,同時量測自動接受結果中的錯誤率與送往覆核的比例,再依佇列、語言和輸入長度拆開看。整體平均可能掩蓋少數高代價錯誤。加入模糊訊息、沒有合適分類的樣本,讓缺少欄位或格式錯誤的結果明確浮現。
用簡單基準做公平比較
保留一批沒有參與指令調整的測試資料。各候選方案收到的必要情境、分類定義與預期結果應一致,並納入規則或既有分類器作為基準。若確定性的規則已能正確解決問題,多一次網路請求未必有益。精確計算、輸入驗證和權限判斷仍適合交給一般程式碼。
記錄模型版本、指令、日期、失敗與應用程式實際觀察到的延遲,不要把失敗請求從統計中刪掉。Jev 公開限制包含精確數值推理及某些模糊語意,這些應納入測試。展示範例、供應商跑分或單一成功案例,都不足以證明你的正式工作負載可用。
比較每個可用結果的總成本
Token 單價只是成本的一部分。還要估算請求、重試、轉交其他模型以及人工覆核的時間,再除以正確完成的工作量。第一通請求便宜,若大多數案例最後仍需另一個模型或人工修正,總成本反而可能更高。
價格參考資料核對於 2026 年 9 月 25 日,之後可能變更。TypeSafe 直接 API、OpenRouter 與本工作空間的服務和計費安排各自獨立。模型供應商的 token 費率不是 Jev API Pro 的訂閱價格,也不代表某方案包含多少工作空間點數;估算前請確認實際存取路徑。
選擇能通過測試的最簡單流程
界線明確的判定通過品質要求,並改善可量測的流程時,可以考慮 Jev。需要撰寫或統整內容時選擇生成模型;答案由精確規則決定時使用一般程式碼。只有在交接責任、輸出契約和失敗處理都清楚時,再把這些步驟串起來。
先做離線樣本測試,再比對建議與實際人員決定,之後才考慮自動分派。事先定義供應商無法連線、回應無效或需要覆核時的處理方式,金鑰留在伺服器端。下一步是實際試用分類契約並檢查輸出,而不是預設替換每一次模型呼叫都會改善產品。