ここでの判定とは何か
ルール一式は 1〜4 個の質問です。choice は 2〜12 個の基準ラベルから 1 つ、noul は true と false の基準に対する yes/no の確率、score は 2〜7 個の順序づけられたレベル上の位置です。1 件のレコードに対して 1 回のリクエストですべてに答え、1 問でも 4 問でも 1 クレジットです。各回答はあなたが送った id と指定した型のまま返り、基準から外れた答えは返却されずに拒否されます。
チャットモデルに文章を採点させるのとは、ここが違います。読むべき生成された理由づけも、解析すべき自由記述の判定もありません。保存されるのは、あなたが書いた問いへの答えです。つまり判定の質は基準の質と同じで、指示が曖昧なら、モデルは「何についてとも言えないもの」に自信を持って答えます。
{
  "text": "INV-2291 の返金が二重に入金され、顧客は 2 件目の送金を止めるよう求めています。",
  "questions": [
    {"id": "outcome", "type": "choice", "instructions": "このメモはどの結果を記録していますか?", "criteria": {"resolved": "問題は解決済み。", "in_progress": "まだ誰かが対応中。", "blocked": "第三者待ち。"}},
    {"id": "is_negative", "type": "noul", "instructions": "このメモは私たちの処理の不具合を報告していますか?", "criteria": {"true": "プロセス上の誤りを報告している。", "false": "進捗や通常の引き継ぎを報告している。"}}
  ],
  "threshold": 0.9
}自分で規則を書くか、生成した草稿を点検する
質問は自分で書けますし、短いプロンプトで判定内容を説明して生成器に提案させることもできます。ログイン済みのセッションから POST /api/judges に、5〜800 文字のプロンプトと言語を送ります。生成器は固定モデル上の chat completion で、その出力は API が受け付けるのと同じ型別化質問に検証されてから表示されます。
生成は 1 クレジットで、失敗すれば返金されます。自動で走るものはありません。生成されたルールは草稿で、あなたが編集してから実行します。基準が相互排他か、レベルが順序づけられているか、個人情報を尋ねる質問がないかを確認してください。プロンプトはデータとして扱います。生成器はルールを書くだけで、何も判定しません。
curl https://jevapi.pro/api/judges \
  -H 'Content-Type: application/json' \
  -H 'Idempotency-Key: judge-support-triage-v1' \
  -b 'jev_session=YOUR_SESSION' \
  -d '{"prompt": "サポートメモが解決済み・対応中・保留のどれかを判定し、私たちの処理の不具合を報告しているかも判定してください。", "locale": "ja"}'\n\n{
  "judge": {
    "name": "サポートメモの確認",
    "questions": [{"id": "outcome", "type": "choice", "instructions": "このメモはどの結果を記録していますか?", "criteria": {"resolved": "…", "in_progress": "…", "blocked": "…"}}]
  },
  "model": "openai/gpt-4.1-mini",
  "id": "6f2c1a4e-9d7b-4c11-8f3a-2b5e9c0d1a77",
  "latencyMs": 2140,
  "credits": 19
}判定を「自信」ではなく人と比べる
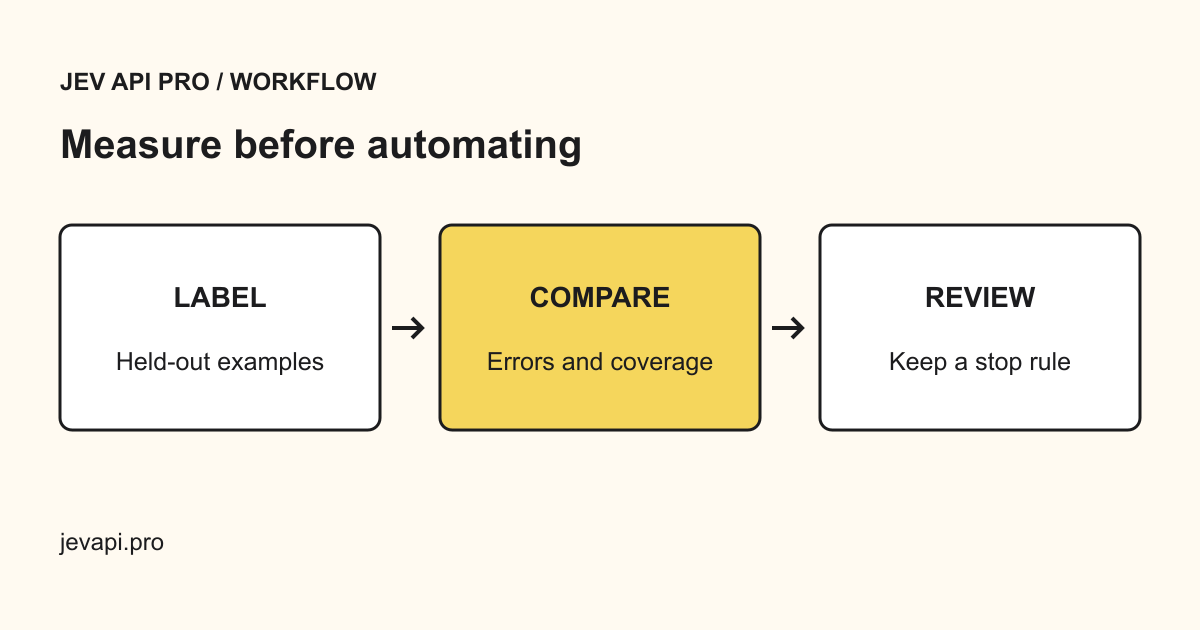
回答を、業務を知る人が書いたラベルと質問ごとに突き合わせ、全体の一致率ではなく、コストの高い誤りを数えます。確率はモデル自身の出力であって、実測した正確さではありません。高い値でも、あなたのデータでは誤っていることがあります。
指示、基準、モデルが変わったら比較をやり直し、リクエスト識別子とモデル名を結果と一緒に保存します。不確実なレコードは人による確認に回し、判定を最終決定として扱わないでください。対外的に示す正確さは、自分たちのホールドアウトからだけ出します。