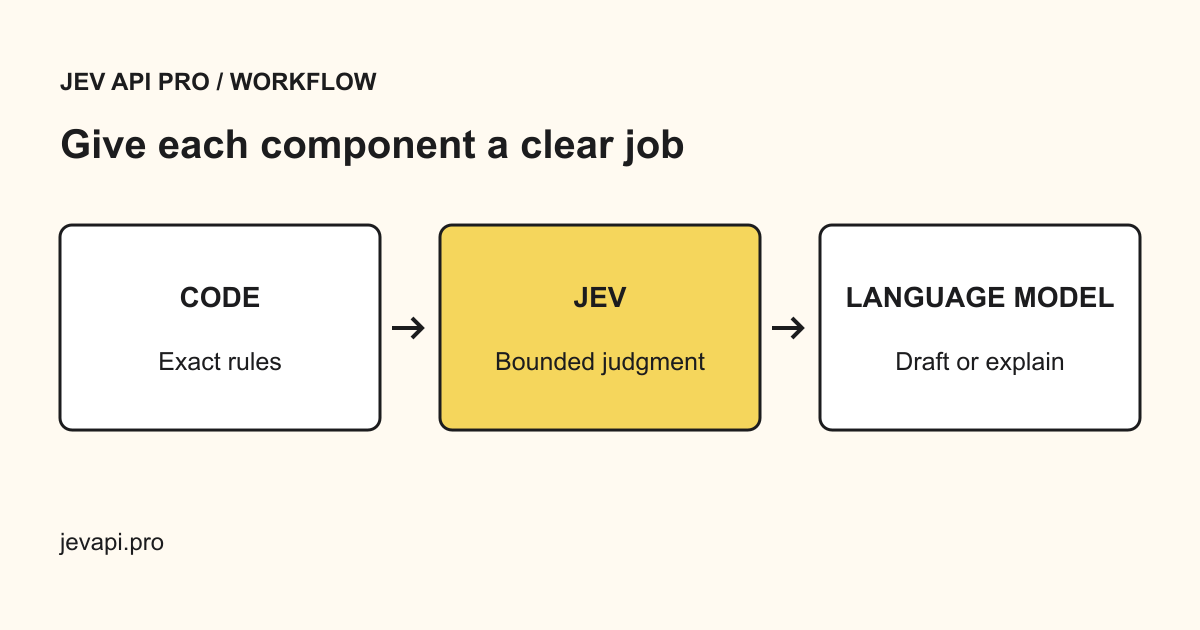
判定は業務フローの一部
チャットモデルは返信の下書きやアイデアの説明に向いています。判定モデルが答えるのは「このチケットはどのキューに渡すべきか」のような、範囲を限定した問いです。取り得る結果を決めるのも、答えを受けて何をするか決めるのも、あなたのアプリケーションです。
上流の Jev は 3 種類の質問を受け付けます。choice(自分で書いた基準から 1 つ選ぶ)、noul(true と false の基準に対する yes/no の確率)、score(順序づけられた評価軸上の位置)です。このワークスペースは 2〜12 個のラベルに対する choice 1 問、または 1 リクエストで最大 4 問の型付き質問を送ります。バッチ画面では短い指示からルールの下書きを作れますが、実行前に自分で編集します。
OpenRouter: TypeSafe SDK と Jev · OpenRouter の Jev チュートリアル · まず判定を試す
構造化されているからといって、間違えないわけではない
許可したラベルが返ることは、想定外の出力形式を防ぐだけです。選ばれたラベルが正しいことの証明にはならず、表示される高い確率はモデル自身の出力であって、あなたのデータで測った精度ではありません。自分の例で評価し、不確実なときの経路を残し、実行前の権限チェックは通常どおり維持してください。
Jev 1.13 の既知の限界
TypeSafe が公開しているこのバージョンの限界(2026 年 9 月 17 日に提供元が確認)には、数え上げ・計算・日付の比較の不安定さが含まれます。これらはコード側で処理してください。無関係な文脈を削り、指示と基準を揃え、否定や間接的な参照は自分の例でテストします。
敵対的な文章は答えに影響しえます。分類器を唯一の認可や安全の制御にしてはいけません。別々の質問が確率の恒等式を満たすとも限りません。ある質問とその否定の確率が 1 になるとは仮定せず、noul で決めた閾値をそのまま choice に移さないでください。
TypeSafe は英語での性能が最も高いと説明しています。画面を翻訳しても、その言語で同じ精度が出ることは意味しません。言語とルールの版ごとに別々に評価してください。
私たちの立場
Jev API Pro は OpenRouter 経由で Jev を呼び出す独立したワークスペースで、TypeSafe でも Jev の公式提供元でもありません。モデルの可用性と挙動は上流のサービスに依存します。本デプロイが要求するのは typesafe/jev-1.13 です。
推論だけが必要で、すでに自分のフローを運用しているなら、提供元へ直接アクセスする方が合うかもしれません。このサービスが足すのは、バッチ画面、確認フラグ、結果の履歴、アカウントの API キー、前払いのクレジットです。独占的なモデルアクセスや最安の推論価格を主張するものではありません。Jev API Pro のキーは本サイトの /api/v1/decisions 用で、OpenRouter や TypeSafe の資格情報ではありません。