Qué devuelve la API de moderación de OpenAI
Según la guía de moderación de OpenAI (consultada el 26 de septiembre de 2026), el modelo actual, omni-moderation-latest, acepta texto e imágenes pero no audio, y el endpoint es gratuito. Las imágenes pueden pesar hasta 20 MB. Puedes llamarlo por separado o pasar un objeto moderation en una petición de Responses o Chat Completions y recibir puntuaciones de la entrada y de la salida generada a la vez.
Cada resultado tiene cuatro partes. flagged es true cuando el modelo considera el contenido potencialmente dañino. categories contiene true o false por categoría. category_scores contiene un valor entre 0 y 1 por categoría, que OpenAI describe como la confianza del modelo. category_applied_input_types indica si la puntuación viene del texto, de la imagen o de ambos.
Hay trece categorías: acoso y acoso con amenazas, odio y odio con amenazas, actos ilícitos y actos ilícitos violentos, autolesión con sus variantes de intención e instrucciones, contenido sexual y contenido sexual con menores, y violencia y violencia gráfica. Varias solo se aplican al texto; si envías una imagen sin texto, esas categorías puntúan 0.
Cuándo el endpoint gratuito es la respuesta correcta
Si tu política equivale a «nada de acoso, odio, contenido sexual, promoción de autolesiones, violencia ni instrucciones para delinquir», el endpoint ya habla tu idioma. No cuesta nada por llamada, cubre imágenes en varias categorías y da puntuaciones por categoría que puedes registrar y usar con umbrales. Para un chat o una caja de comentarios en un sitio pequeño es un primer filtro razonable, y no tiene sentido pagar por otro sistema que vuelva a etiquetar las mismas categorías.
La propia guía hace dos advertencias. OpenAI planea actualizar el modelo de forma continua, así que las reglas que dependan de valores exactos de category_scores pueden necesitar recalibración. También pide tratar las puntuaciones como señales para tu política y no como un bloqueo automático; incluso una negativa que habla de contenido dañino puede quedar marcada. Y no es una herramienta para detectar material de abuso sexual infantil, que requiere salvaguardas y canales de denuncia específicos.
Dónde se queda corta una taxonomía fija
Las políticas reales incluyen reglas que ningún modelo general de daños aprendió a aplicar: nada de ventas fuera de la plataforma, nada de enlaces de referido, nada de teléfonos personales en reseñas públicas, nada de dosis médicas en un foro de crianza, nada de ofertas de empleo en una comunidad de soporte. Ninguna encaja con las trece categorías, y un comentario puede ser educado y aun así incumplir tus normas.
También ocurre lo contrario. Una comunidad de noticias puede permitir descripciones gráficas en reportajes, y un foro de recuperación puede conservar mensajes que mencionan autolesiones mientras escala los que expresan intención. Una marca de un modelo general es entonces el inicio de una pregunta, no la respuesta. Necesitas un clasificador que lea tu política escrita, elija entre resultados que tú definiste y diga cuándo duda.
Clasificación con tu política en Jev API Pro
Jev API Pro recibe el texto, tus instrucciones y las etiquetas permitidas, y devuelve una de esas etiquetas con un valor de confianza cuando el modelo lo aporta, además de needsReview cuando la respuesta queda por debajo de tu umbral. Un conjunto habitual es permitir, revisar y bloquear, pero las etiquetas pueden ser la lista que tu equipo ya usa. Solo acepta texto; no modera imágenes, audio ni vídeo.
No es gratuito. Cada solicitud cuesta un crédito; con los precios publicados el 26 de septiembre de 2026 son unos 0,019 $ por decisión en el paquete de 1.000 créditos por 19 $, y entre unos 0,0083 $ y 0,0039 $ en los planes anuales. El texto se envía desde el servidor a OpenRouter y al proveedor del modelo, como explica la página de seguridad, así que revisa esa cadena de tratamiento antes de enviar contenido de usuarios.
{
  "text": "Escríbeme por privado y te paso un código del 40 %, más barato que la tienda oficial.",
  "instructions": "Aplica nuestra política de comentarios del marketplace. Bloquea ventas fuera de la plataforma, revisa la promoción dudosa y permite el resto.",
  "labels": ["permitir", "revisar", "bloquear"],
  "threshold": 0.85
}
Clasificación para moderar contenido · Adónde va el texto enviado · Precios
Combínalas en capas en lugar de elegir una
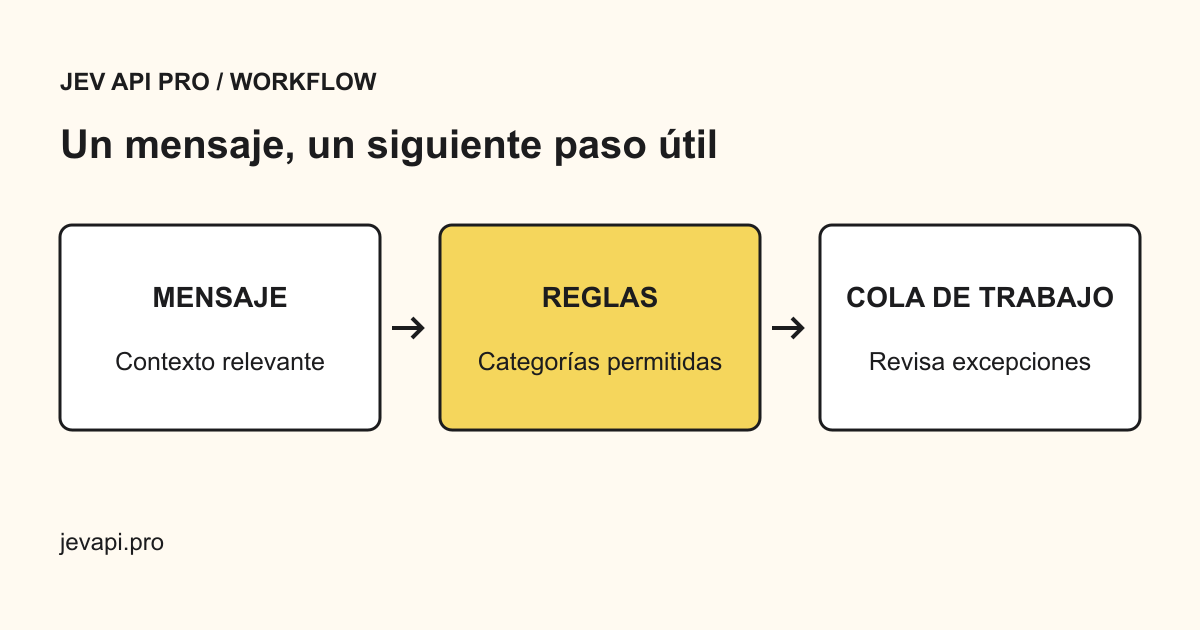
Las dos herramientas responden preguntas distintas, así que muchos equipos usan ambas. Envía cada elemento primero al endpoint gratuito y actúa en las categorías donde tu política es clara. Envía el resto, o solo las superficies donde importan tus reglas, a un clasificador con tus etiquetas. Lo marcado con needsReview y todas las apelaciones van a una persona. Así el paso de pago es pequeño y las personas se ocupan de los casos que requieren criterio.
Si prefieres ejecutar el modelo tú mismo, los modelos de salvaguarda con pesos abiertos son una tercera vía. Meta describe Llama Guard 4 como un modelo de 12.000 millones de parámetros que funciona en una sola GPU, lee texto con imágenes, responde safe o unsafe con códigos de categoría y acepta descripciones de categorías propias en el prompt. Meta advierte que está optimizado para texto en inglés, así que prueba otros idiomas antes de confiar en él.
Capa 1  API de moderación de OpenAI  gratis   13 categorías fijas   texto + imágenes
Capa 2  Tu clasificador de política  de pago  tus etiquetas         texto
Capa 3  Personas                     equipo   apelaciones, dudas    todo
Página del modelo Llama Guard 4 · Decisiones con revisión humana
Evalúa antes de aplicar medidas
Reúne unos cientos de elementos reales, incluidos los denunciados, y pide a dos personas que los etiqueten según tu política antes de mirar ninguna salida de modelo. Compara después cada capa con esas etiquetas, categoría por categoría, y cuenta por separado falsos positivos y falsos negativos: los primeros silencian a usuarios legítimos y los segundos exponen a otros a daños. Guarda el nombre del modelo, el umbral y la fecha de cada prueba, porque ambos proveedores pueden cambiar el modelo detrás del mismo nombre.
Empieza en modo sugerencia, donde el clasificador propone y un moderador decide, y automatiza solo los resultados que se mantuvieron precisos en tu conjunto reservado. Publica una vía de apelación. Una puntuación, de cualquier proveedor, no es una conclusión legal y nunca debe presentarse así a un usuario.
Evalúa la clasificación antes de automatizar · El LLM como juez: reglas tipadas auditables