檢查型別化請求,不預先保證答案
下方範例針對同一則訊息,提出一個 choice 選項問題和一個是非機率問題。兩題判斷不同面向:哪個佇列負責,以及是否缺少必要資訊。這段 JSON 是請求輸入,不是即時執行結果,也不保證模型一定回傳某個答案。
回應格式有效,仍需要檢查答案範圍。確認每個問題 ID 都有回應、型別一致,而且所選標籤屬於提供的 criteria。缺少信心值時應送往覆核,不能補上一個假造的預設分數。本 API 會先驗證供應商回應,再把它視為已完成的判定。
{
  "text": "我的 CSV 匯出缺少日期欄位。",
  "questions": [
    {
      "id": "queue",
      "type": "choice",
      "instructions": "選擇負責處理所述問題的團隊。",
      "criteria": {
        "support": "使用方式或帳戶問題。",
        "engineering": "功能故障或缺少應有行為。"
      }
    },
    {
      "id": "needs_details",
      "type": "noul",
      "instructions": "是否缺少重現問題的必要資訊?",
      "criteria": {
        "true": "操作步驟或受影響的匯出內容不清楚。",
        "false": "已有足夠情境可以重現問題。"
      }
    }
  ],
  "threshold": 0.9
}
把文字生成留在另一個步驟
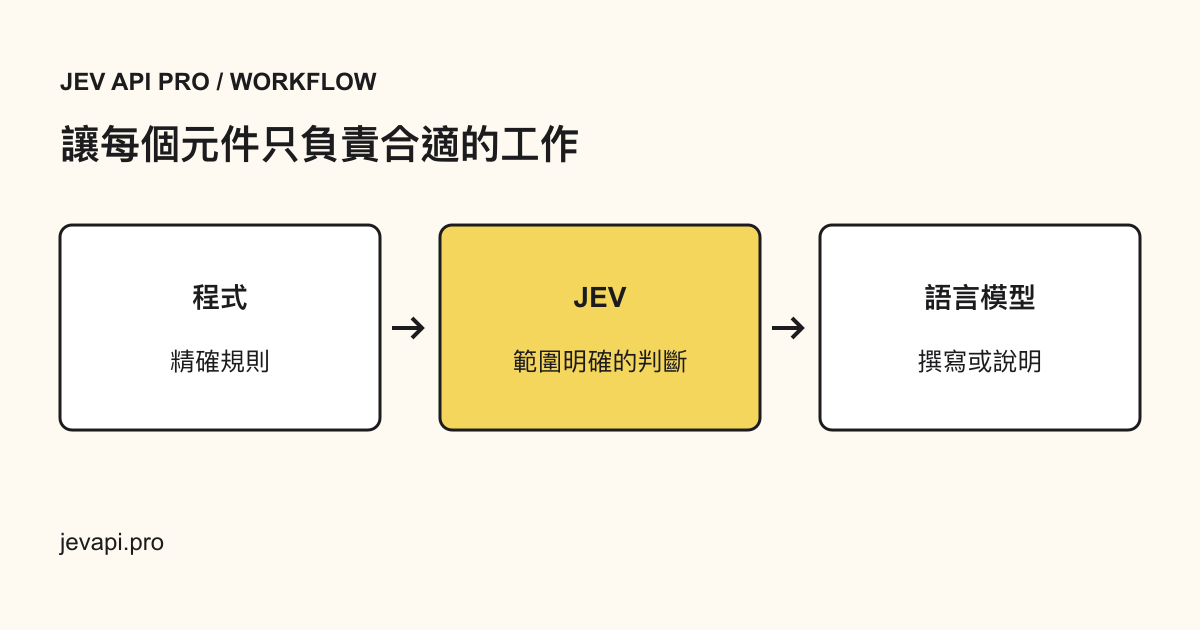
如果流程還需要回覆客戶,可以在分派判定之後,把已核可的情境交給生成模型。不要要求 Jev 撰寫它不會回傳的理由。介面上應明確區分生成草稿與分類器輸出,寄出前再覆核草稿。
將完整流程與較簡單的程式規則、既有生成模型方案比較。成本應包含重試、失敗請求、覆核時間與串接工作。容易解析的格式有助於提升工程可靠性,但不能直接證明任務正確率更高。
什麼時候選一個答案就足夠
分派、標記與優先順序判斷的下一步,可能只需要少數標籤中的一個。判定介面把候選結果列清楚,也能提供機率資訊,不必先要求模型寫一段解釋。
什麼時候生成文字才是產品
草擬客戶回覆、摘要長篇報告,或擷取內容不固定的欄位,可能需要支援結構化輸出的語言模型。本工作空間不宣稱 Jev 可以取代所有文字生成任務。
比較可接受的結果,不只比較格式
使用同一批已標記樣本,比較正確率、延遲、失敗率、覆核量,以及每個可接受結果的總成本。有效 JSON 只代表格式符合要求,不代表內容正確。不要把供應商的公開跑分直接當成模型在你資料上的效能證據。