Qué significa clasificación zero-shot
En la clasificación supervisada clásica reúnes cientos o miles de ejemplos etiquetados por categoría, entrenas un modelo y lo vuelves a entrenar cada vez que cambian las categorías. La clasificación zero-shot se salta ese entrenamiento específico. Un modelo que ya entiende el lenguaje recibe las etiquetas candidatas en el momento de la solicitud y elige la que mejor encaja con el texto. El «cero» cuenta los ejemplos etiquetados de tu tarea que ha visto el modelo, no el trabajo que te queda por hacer.
La idea es anterior a los grandes modelos de lenguaje. La investigación sobre aprendizaje zero-shot describía cómo reconocer clases ausentes del entrenamiento relacionándolas con cosas que el modelo ya conocía. En texto, un enfoque muy conocido convierte la clasificación en inferencia de lenguaje natural: cada etiqueta se transforma en una hipótesis como «Este texto trata de facturación» y un modelo entrenado en implicación puntúa cuánto la respalda el texto. El pipeline zero-shot-classification de Hugging Face popularizó ese enfoque con modelos NLI como BART ajustado en MNLI. Los modelos de lenguaje con instrucciones lo simplificaron todavía más: las etiquetas y una regla breve van en la solicitud y el modelo devuelve una elección.
Zero-shot, few-shot y modelos ajustados
Zero-shot usa solo etiquetas e instrucciones. Es la forma más rápida de empezar, no exige recopilar datos y permite que las categorías cambien de una solicitud a otra. Es más débil cuando una etiqueta depende de la jerga de la empresa o de un límite de política sutil que el modelo no puede deducir solo de las palabras.
Few-shot añade a la solicitud unos pocos ejemplos resueltos. Eso suele corregir una frontera confusa entre dos etiquetas, a cambio de solicitudes más largas y del riesgo de que el modelo copie rasgos superficiales de los ejemplos, como su longitud o su tono, en lugar de la regla.
Un modelo ajustado se entrena con tus propios datos etiquetados. Con mucho volumen y un conjunto de etiquetas estable suele ser la opción más consistente, pero necesita un conjunto de datos etiquetado, un proceso de entrenamiento y un plan para reentrenar cada vez que cambian las categorías. Un camino práctico es empezar con zero-shot, medir dónde falla, añadir algunos ejemplos para esas fronteras y plantearse el ajuste solo cuando el volumen y una taxonomía asentada justifiquen el mantenimiento.
Cómo se construye una solicitud zero-shot
Toda solicitud zero-shot tiene tres partes: el texto que se clasifica, la lista de etiquetas permitidas y una instrucción que explica cómo elegir entre ellas. Las etiquetas son el contrato. Si el modelo solo puede responder con una de ellas, tu código nunca tiene que interpretar prosa libre y una respuesta fuera de la lista se puede rechazar en lugar de adivinarse.
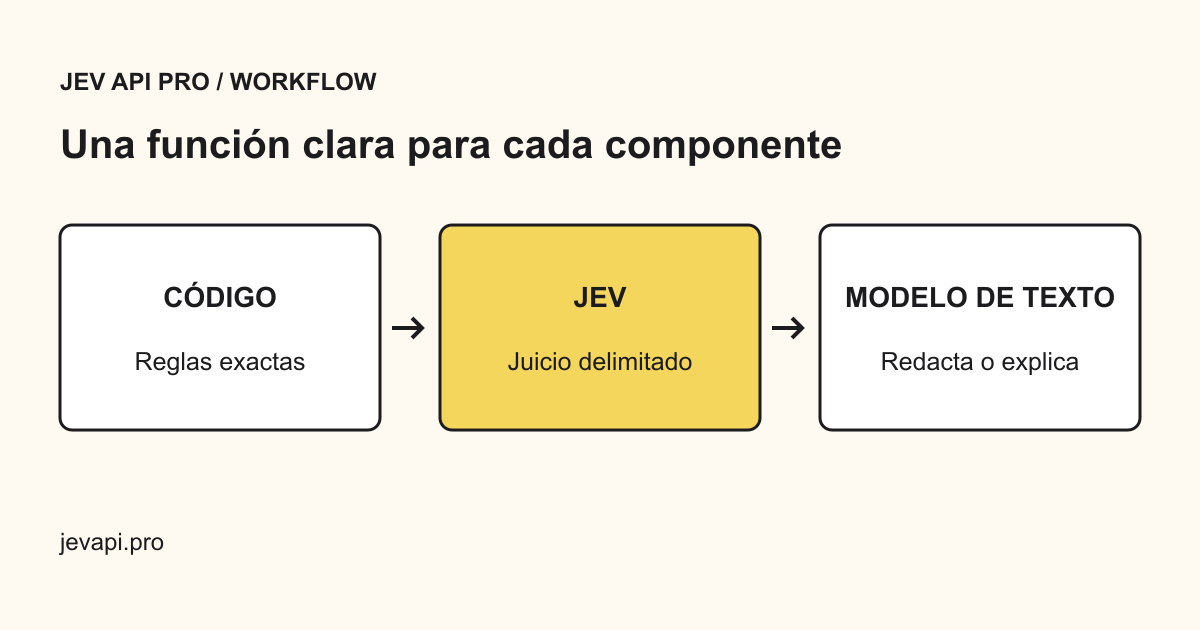
Jev API Pro está construido alrededor de ese contrato. Envías el texto, tus instrucciones y las etiquetas, con un umbral de confianza opcional, y recibes una de tus etiquetas con un valor de confianza cuando el modelo lo proporciona. Un resultado por debajo del umbral se marca para revisión en vez de tratarse como definitivo. La solicitud de abajo se puede pegar tal cual en el área de pruebas.
{
  "text": "Me cobraron dos veces la factura de marzo, devolvedme uno de los cargos.",
  "instructions": "Elige el equipo que puede resolver la solicitud. Usa otro si ninguno aplica.",
  "labels": ["facturación", "soporte técnico", "acceso a la cuenta", "otro"],
  "threshold": 0.8
}
Prueba esta solicitud en el área de pruebas · Contrato de solicitud y respuesta
Etiquetas que un modelo puede distinguir
La mayoría de los errores zero-shot vienen del conjunto de etiquetas, no del modelo. Las etiquetas que se solapan, como «queja» y «problema de facturación», obligan al modelo a elegir una dimensión que nunca especificaste. Da a cada etiqueta un solo eje: quién es responsable del trabajo, qué acción se pide o qué política aplica. Si necesitas dos ejes, como tema y sentimiento, haz dos decisiones distintas.
Usa palabras sencillas que el modelo ya conoce en lugar de códigos internos: «solicitud de reembolso» es más fácil que «FIN-2». Si un nombre interno es inevitable, explícalo una vez en la instrucción. Incluye siempre una etiqueta de escape como «otro» o «necesita aclaración», para que un mensaje que no encaja en nada tenga un destino honesto.
Mantén la lista corta. Entre cinco y diez etiquetas bien separadas se evalúan mucho mejor que cuarenta. Cuando la taxonomía es grande, dirige primero a una familia y clasifica dentro de ella en una segunda decisión.
Dónde falla la clasificación zero-shot
La negación y las citas son las trampas clásicas: «No canceles mi cuenta» contiene la palabra cancelar. Las solicitudes mixtas son otra: un mensaje que pide un reembolso y un cambio de contraseña tiene dos respuestas correctas si tu regla no indica cuál es la principal. El lenguaje del sector también cuenta, porque nombres de producto, abreviaturas y expresiones regionales quizá nunca aparecieron en el contexto del que aprendió el modelo.
Las instrucciones escondidas dentro del texto son un riesgo aparte. Un mensaje de cliente puede contener frases que parecen órdenes para el modelo. Trata la entrada como evidencia que se clasifica, dilo en la instrucción y nunca permitas que una clasificación por sí sola dispare una acción irreversible, como un reembolso o la eliminación de una cuenta.
La confianza ayuda, pero no es una garantía: un modelo puede equivocarse con total seguridad. Usa el umbral para decidir qué ve una persona y calíbralo con tus propios ejemplos etiquetados en lugar de fiarte de un valor por defecto.
Cómo elegir un umbral de confianza · Revisión humana de decisiones
Prueba antes de automatizar
Reúne entre 100 y 300 mensajes reales, elimina los datos personales y pide a las personas responsables del trabajo que los etiqueten. Pasa el mismo conjunto por tu regla zero-shot y compara las respuestas. Fíjate en las confusiones entre etiquetas que llevan a acciones distintas; una sola cifra de exactitud global puede ocultar un error caro, como cancelaciones que acaban en la cola equivocada.
Empieza en modo sugerencia: escribe la etiqueta prevista en un campo y deja que tu equipo la acepte o la corrija. Registra las correcciones por etiqueta. Automatiza una ruta reversible cuando su tasa de error sea aceptable, deja los resultados de baja confianza a una persona y repite la evaluación cada vez que cambies las etiquetas o la instrucción.
Cómo evaluar un clasificador · Clasifica un archivo completo por lotes